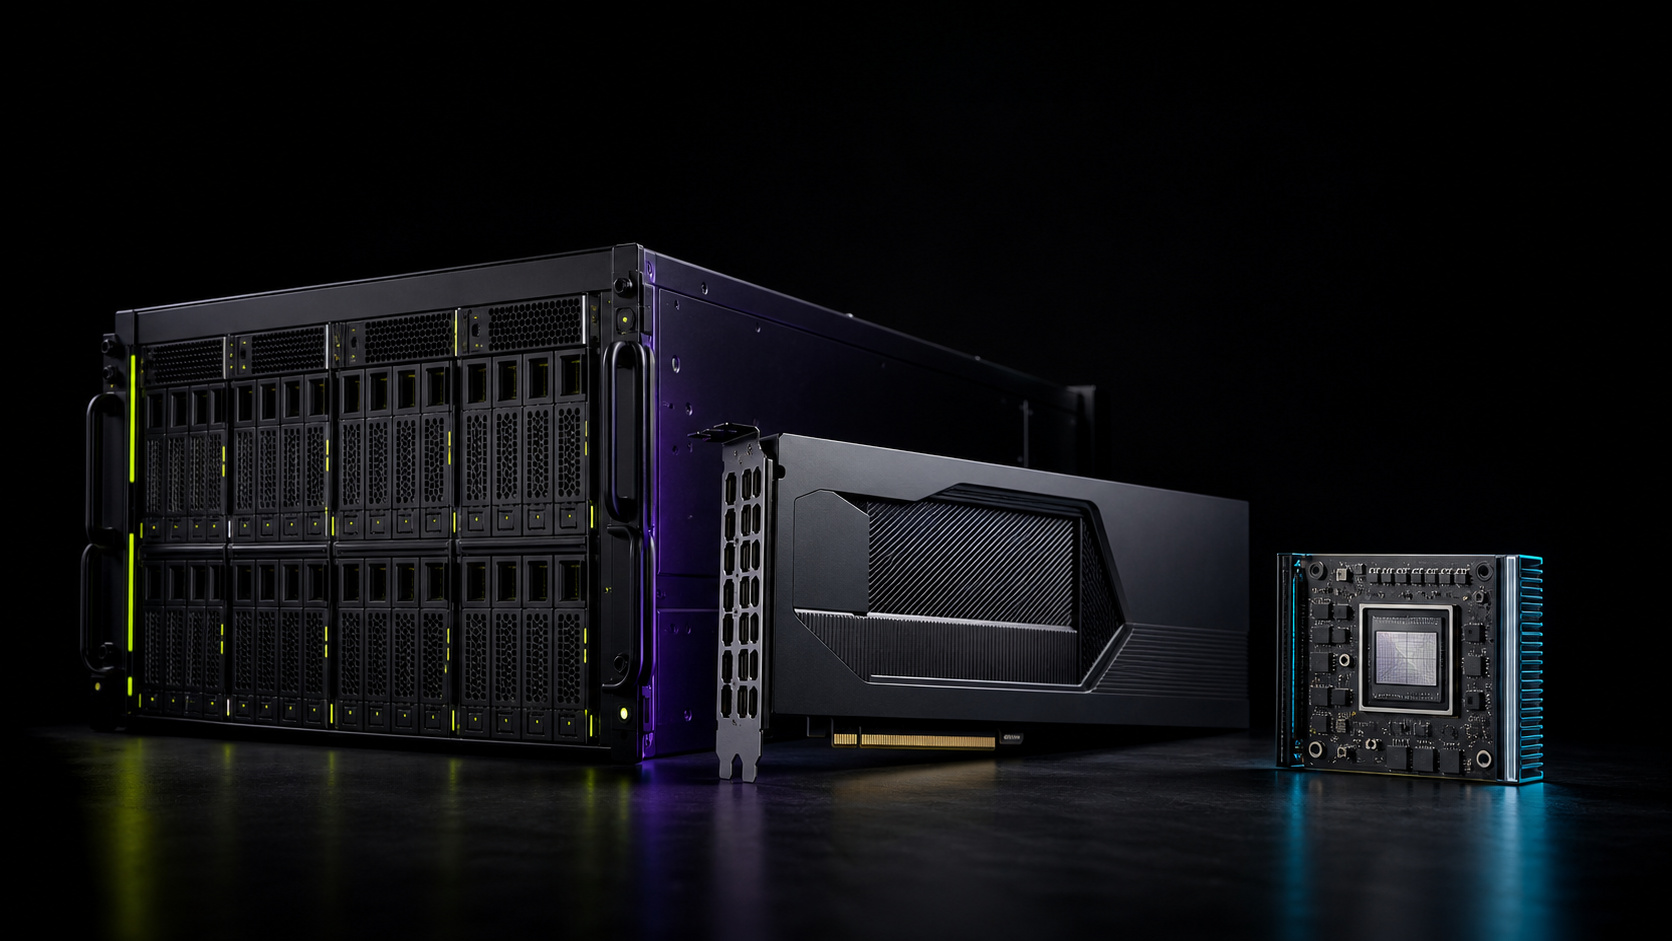
COMPUTE AT EVERY SCALE

从云端,
到边缘。

AETHER、NOVA 与 SPARK 共享同一开放计算底座,让模型跨场景部署不再被硬件割裂。

WHY HOLYCORES

让先进 AI 到达 每一个需要它的地方。

真正有价值的算力,不只存在于基准测试中。它需要进入企业、城市、设备和真实工作流程,在性能、成本、隐私与可持续性之间建立新的平衡。
01

更广泛地使用 AI

从集中式基础设施延伸到企业本地和现场设备,让不同规模的团队都能选择合适的计算形态。

02

更接近数据与决策

缩短数据移动路径,让对响应时间敏感的模型在需要结果的位置运行。

03

更清晰的数据边界

通过本地与私有化部署,为敏感数据、行业合规和关键业务提供更明确的控制方式。

04

更可控的系统经济性

围绕真实利用率、容量、能耗与运营方式评估系统,而不是只比较孤立峰值。

05

更负责任的计算

以数据流、软硬件协同和分层部署减少不必要的数据搬运与资源浪费。

ONE FOUNDATION / THREE SCALES

同一平台,沿着工作负载自然扩展。

AETHER云端规模化NOVA数据中心加速SPARK边缘本地智能

HARDWARE PORTFOLIO

从开发验证, 到规模化部署。

真实的硬件图让产品边界更清晰。HOLYCORES 以可安装、可散热、可互联的产品形态承载芯片与软件能力。
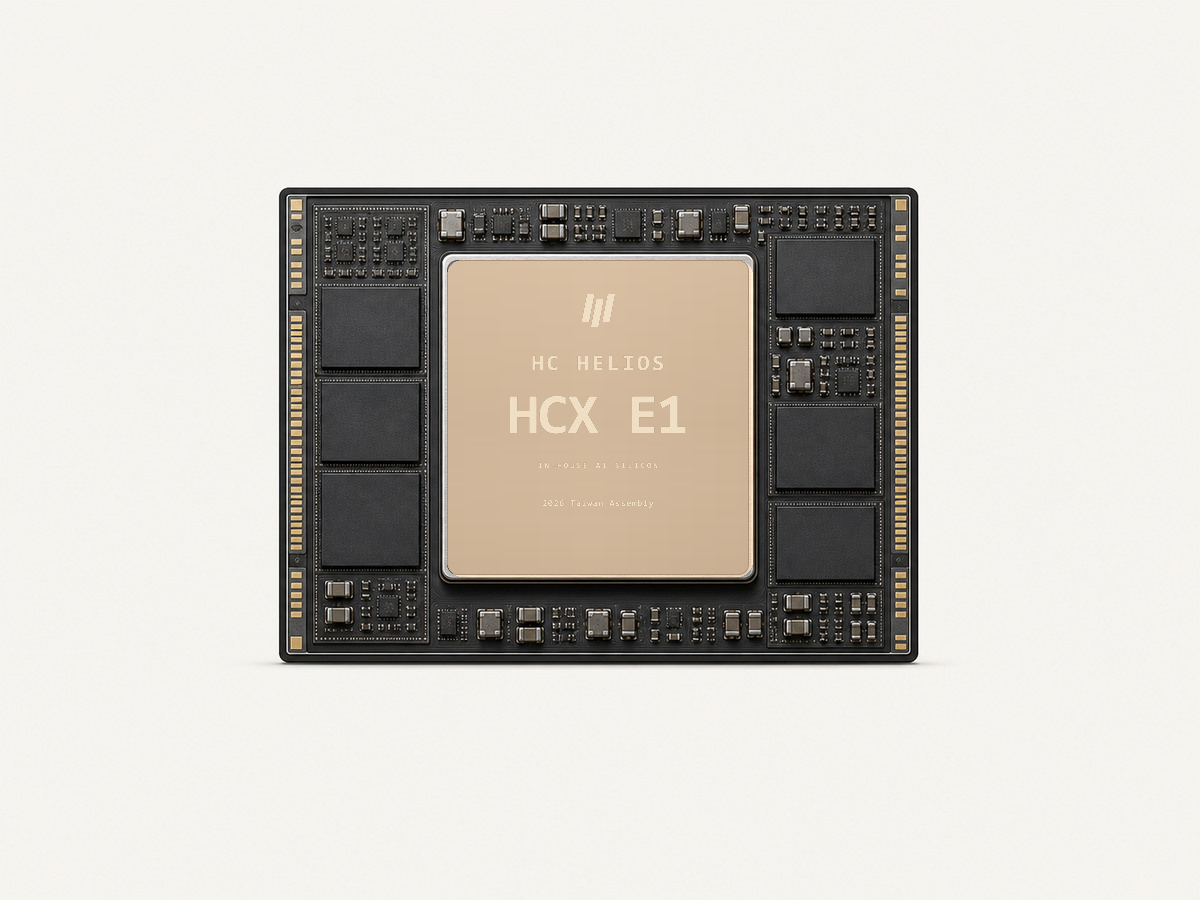
HELIOS HCX E1 自主设计 AI 裸芯片产品图
IN-HOUSE SILICON / AI COMPUTE

HELIOS HCX E1

自主设计,从芯开始。面向数据中心、边缘设备与先进封装,构建统一计算、存储、互联和软件接口。
  • 自主可编程计算架构
  • 分层片上存储与数据流互联
  • HOLYFLOW 软硬件协同
查看 HELIOS 元芯 →
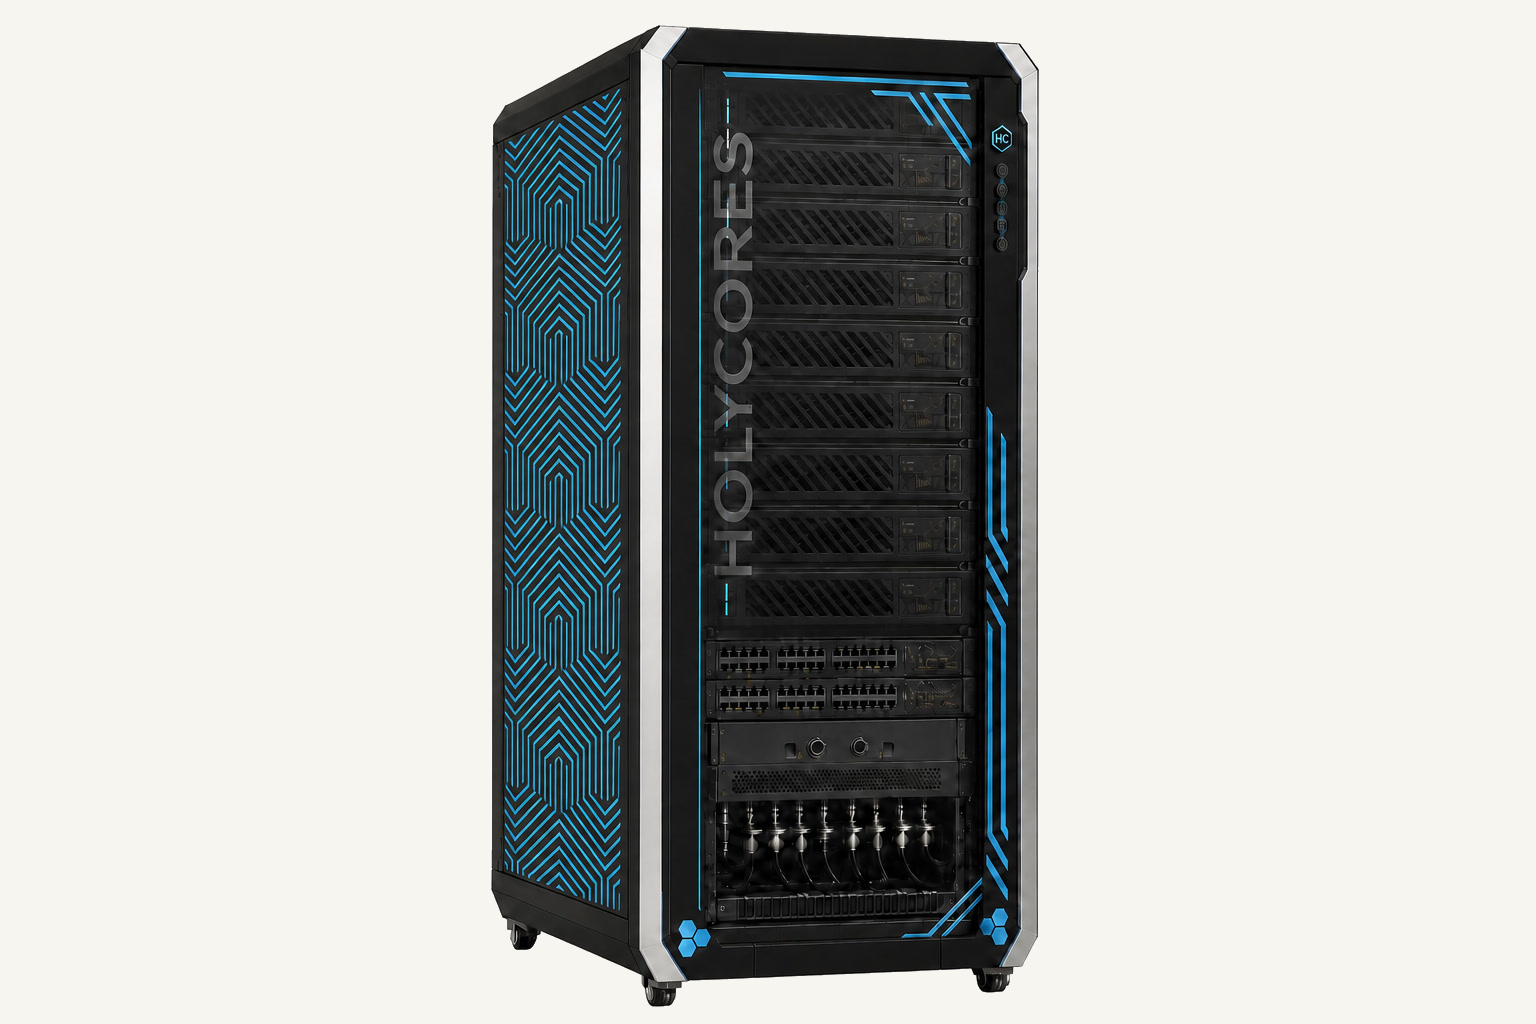
AETHER A72 整柜 AI 系统概念图
CLOUD / RACK-SCALE SYSTEM

AETHER A72

把计算、互联、液冷、遥测与管理整合为一个面向生产的完整机柜系统。

  • 最多 72 张加速器规划规模
  • 整柜 HC-Fabric 互联
  • 一体化液冷规划
查看 AETHER 系统 →
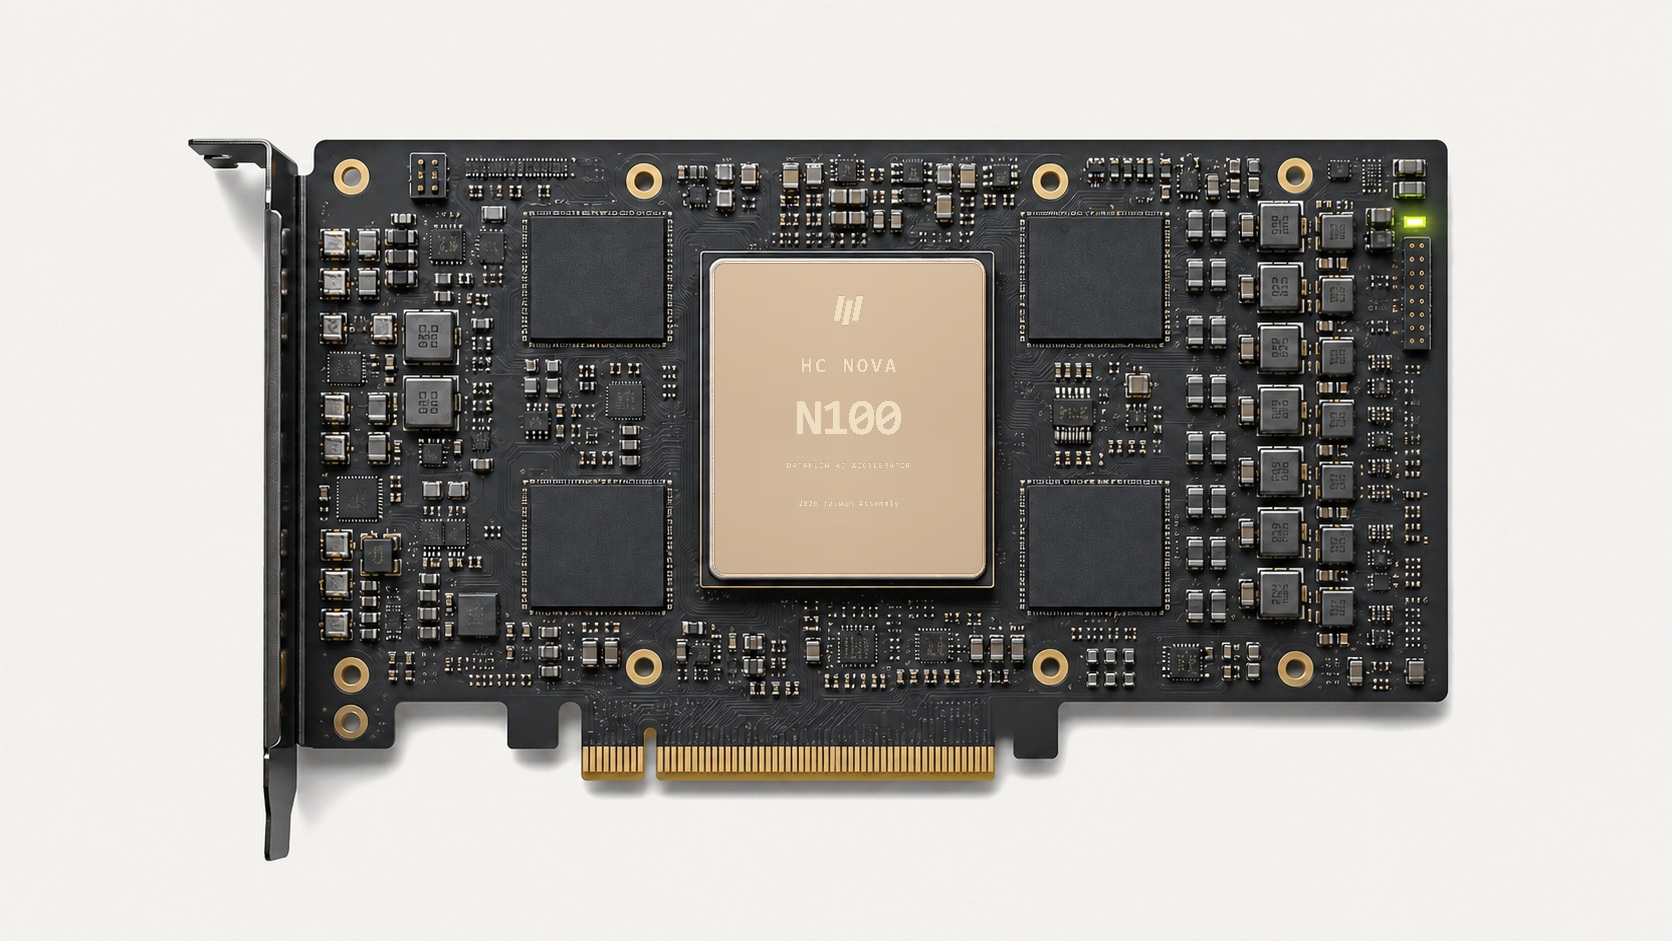
NOVA N100 单芯片 PCIe AI 加速卡概念图
DATACENTER / SINGLE ACCELERATOR

NOVA N100

面向开发工作站、私有 AI 与通用推理服务器的单芯片 PCIe 加速卡。

  • PCIe 5.0 ×16 主机接口
  • 24 GB 目标显存
  • 双槽主动散热规划
查看 NOVA 系列 →
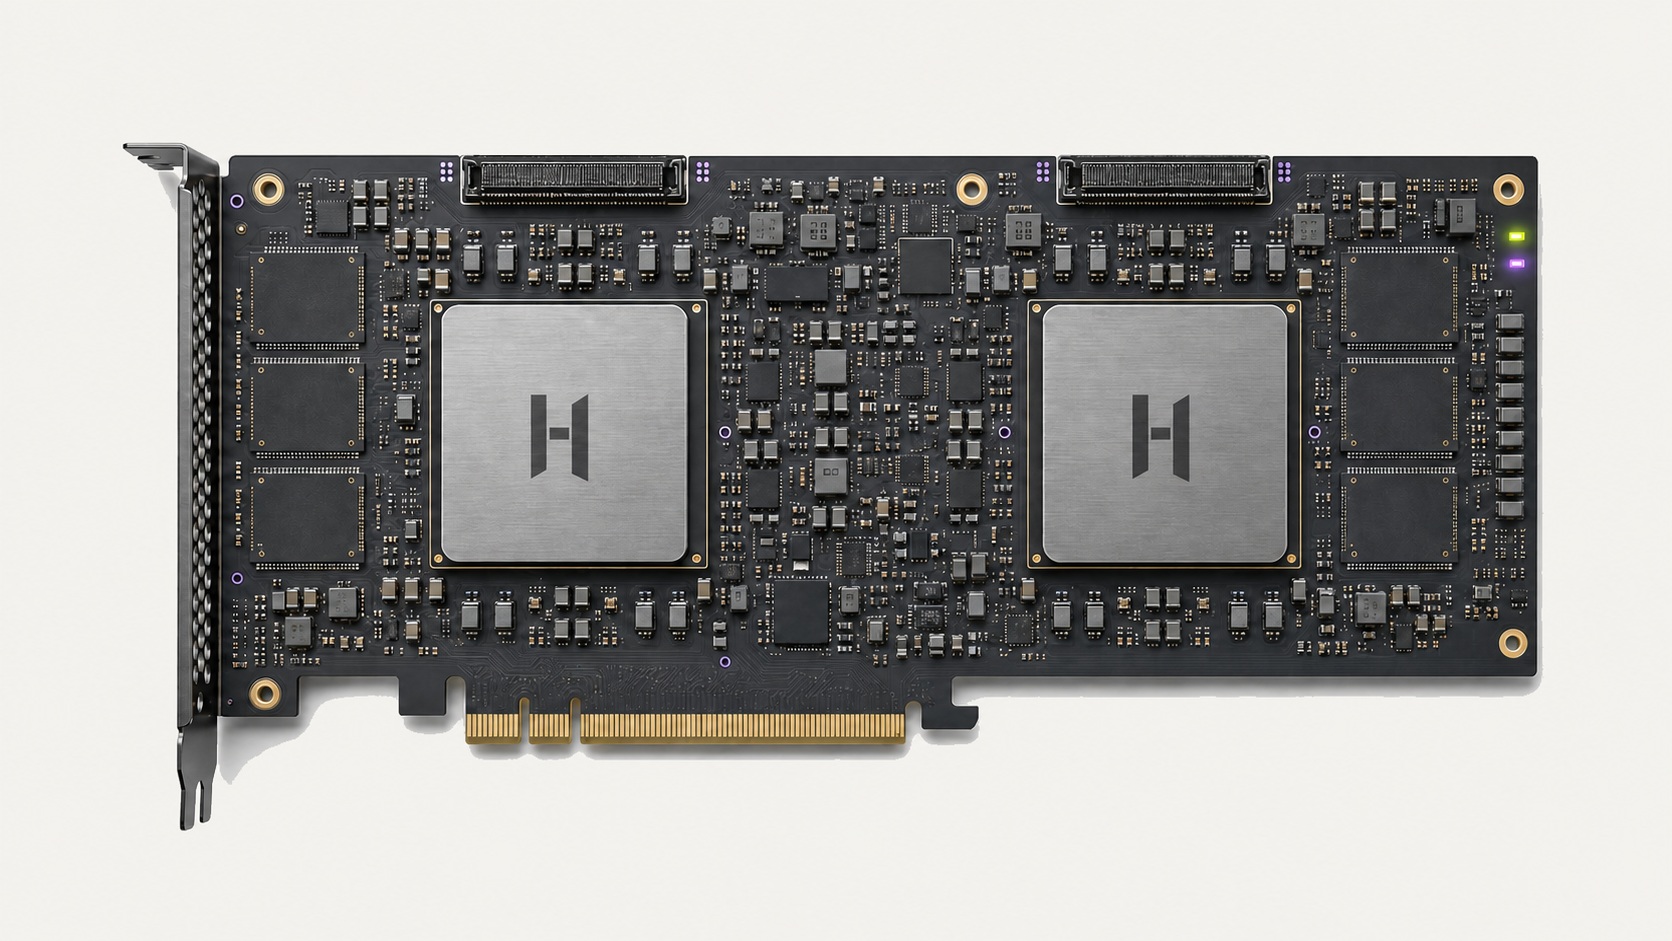
NOVA N200 双芯片 PCIe AI 加速卡概念图
DATACENTER / SCALE-OUT

NOVA N200

以双芯片和专用卡间互联面向高吞吐推理、多卡扩展和高密度服务器。

  • 双芯片计算基板
  • 48 GB 目标显存
  • 主动与被动散热版本
比较 NOVA 型号 →
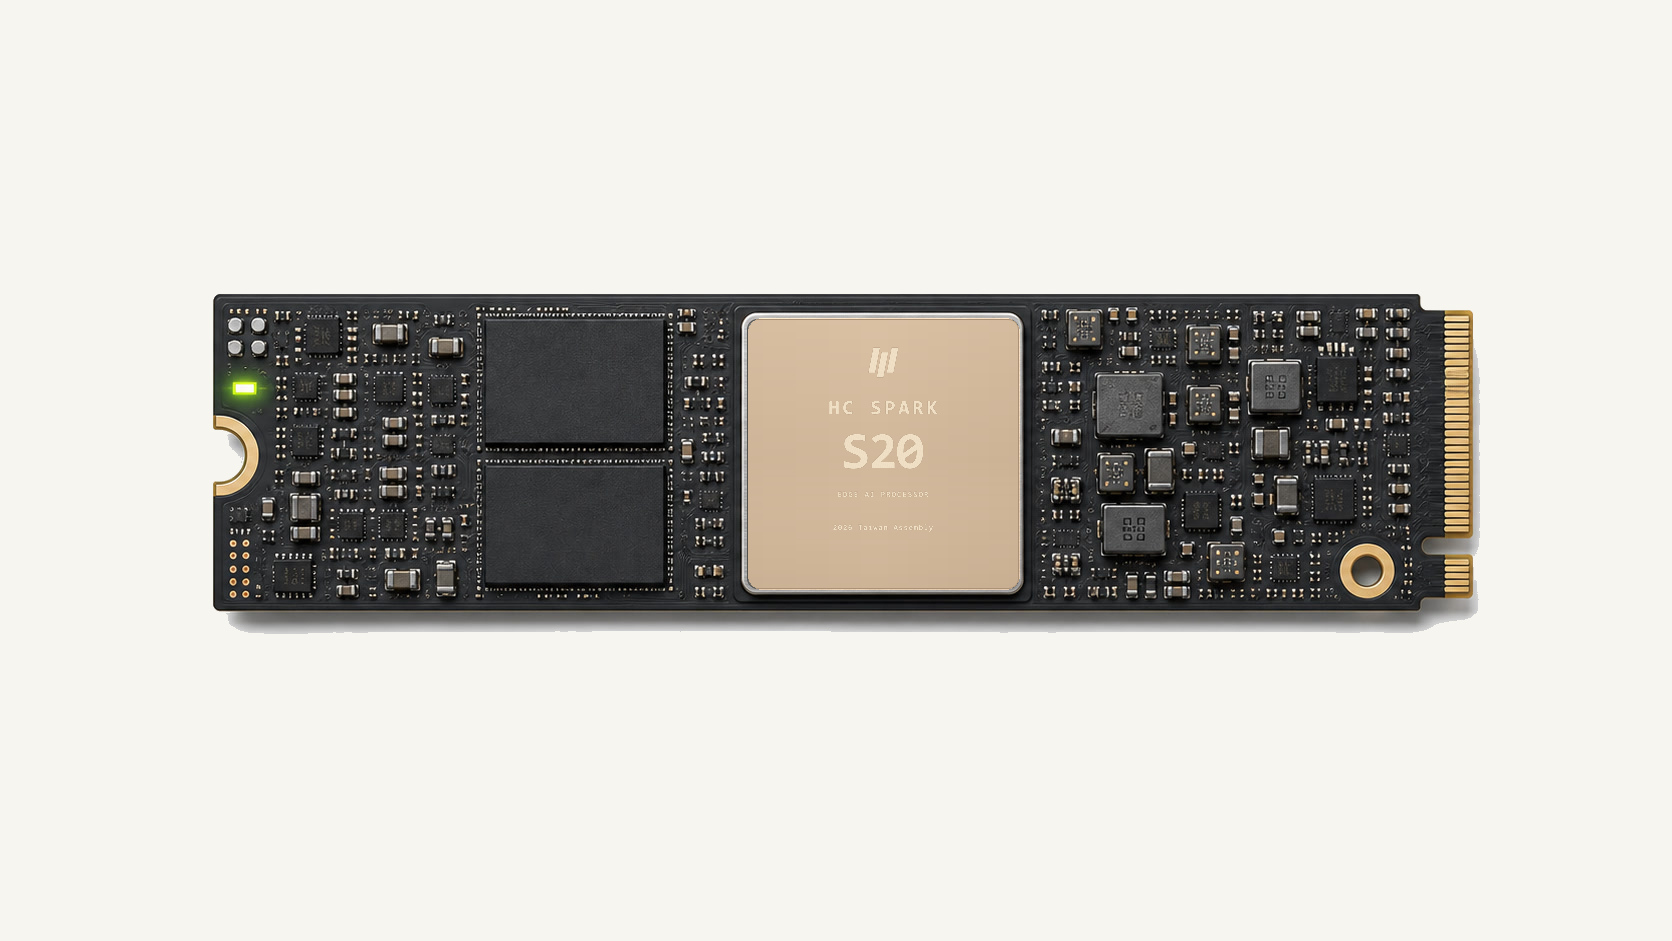
SPARK S20 M.2 边缘 AI 模组概念图
EDGE / EMBEDDED MODULE

SPARK S20

为机器人、机器视觉与智能终端提供紧凑、低功耗的本地推理模组。

  • M.2 紧凑形态
  • 本地模型与传感器路径
  • 15 W 级目标功耗
查看 SPARK 系列 →

COMPARE NOVA MODELS

同一架构, 面向不同系统边界。

下列数据用于产品规划与客户联合验证,不代表已经量产或完成认证的最终规格。
规划维度NOVA N100ANOVA N200ANOVA N200P
产品形态单芯片主动散热卡双芯片主动散热卡双芯片被动散热卡
相对计算规模1× 基准约 2× N100A约 2× N100A
目标显存容量24 GB48 GB48 GB
主机接口PCIe 5.0 ×16PCIe 5.0 ×16PCIe 5.0 ×16
卡间互联主机 PCIe2× HC-Fabric2× HC-Fabric
目标板卡功耗不高于 225 W不高于 350 W不高于 300 W
散热形态双槽主动散热2.5 槽主动散热双槽被动散热
目标部署开发工作站、推理服务器高吞吐推理、多卡节点高密度机架服务器

规划目标可能随芯片、板级、散热与系统验证结果调整;正式供货型号、兼容性与规格以未来发布的产品资料为准。

一条从云端到边缘的连续产品路线

三种部署尺度共享架构、软件与工程方法,而不是彼此割裂的设备。
01

AETHER 云核

集群级训练与规模推理,统筹计算、互联、散热与运维。

02

NOVA 星核

数据中心开放 AI 加速平台,兼顾性能、可编程性与多卡扩展。

03

SPARK 灵核

机器人、视觉与工业终端中的低功耗实时本地推理。

核心方法

先确定部署位置,再确定系统边界。

从模型规模、延迟、功耗、数据边界和运营方式出发,而不是只比较峰值指标。

01云端集群 / 最大规模与资源池化
02数据中心 / 专属算力与可控运营
03边缘现场 / 低延迟与离线自治
04统一软件 / 模型资产跨平台延续

产品组合

三种尺度,共享一个技术底座。

SYSTEM

AETHER

把加速器、互联、网络、散热和集群软件作为整体。

继续了解 →
DEVICE

NOVA

为服务器节点提供可编程计算、片上数据流与多卡扩展。

继续了解 →
FIELD

SPARK

把推理、传感器路径、设备管理和可靠性带到数据源附近。

继续了解 →

选择依据

用真实约束缩小选择范围。

模型与规模

模型与规模

参数量、上下文、并发、训练或推理决定计算形态。

时延与位置

时延与位置

交互式服务、闭环控制和离线运行决定部署距离。

功耗与空间

功耗与空间

机房、服务器、机柜和终端拥有不同的热设计边界。

数据与运营

数据与运营

隐私、网络、升级、监控和维护共同影响总体方案。

采用路径

从单点验证走向跨尺度平台。

01

开发验证

以代表性模型建立精度、性能和工具链基线。

02

目标环境集成

完成主机、网络、散热、接口及运维系统适配。

03

规模扩展

依据容量与服务目标扩展为集群或边缘设备群。

产品评估输入

带着工作负载,而不是只带一张规格表。

INPUT

准备背景

说明模型、场景、部署环境与关键约束。

BASELINE

提供基线

记录当前方案、指标和希望解决的问题。

DECISION

明确决策点

定义验证后需要回答的业务与技术问题。

开始沟通 →

FAQ

产品选择中的常见问题

如何选择三类产品?+

先确定工作负载位置和系统边界,再评估模型规模、延迟、功耗与运营约束。

能否共享模型资产?+

路线以 HOLYFLOW 为共同软件底座,具体兼容范围将在验证后公布。

01 / AETHER / 天穹

面向主权 AI 的云端智算系统

高密度计算节点、高带宽互联与统一管理软件构成可横向扩展的生产级 AI 基础设施。

02 / NOVA / 星核

数据中心 AI 加速平台

开放、可编程的 AI 加速卡,为模型训练、微调和推理提供高效算力。

03 / SPARK / 灵核

把智能带到每一个边缘节点

低功耗推理芯片面向机器人、机器视觉与端侧智能。

准备好开始了吗?

带上你的工作负载, 我们提供计算平台。

hello@holycores.com →